Mac 中英混合听写:英文词听错时怎么修正
中文里夹英文被听错时,先区分识别与清稿的问题,再检查个人词典、精确替换、音频校验与本地模型,避免修对一处却改错其他词。
ListenIn 操作步骤于 2026 年 10 月 12 日依据 0.3.7 测试构建核实。当日公开下载仍为 0.3.6,较新的控件可能尚未包含在该公开版本中。 查看公开版本
先看结论
中英混合听写里的英文词出错,先在听写历史中对照原稿和成稿。ListenIn 使用 Apple 本机识别,并结合保守纠错、个人词典和按 App 设置的精确替换。它们可以提供帮助,但一句话读起来通顺,不等于英文词就识别正确了。
「这一段保持 unchanged」和「这一段 changed」可能表达相反的修改要求。中文里的英文并非装饰,它可能是必须保留的条件、产品名或标识符。听写工具需要保留意思,不能只让句子读起来通顺。
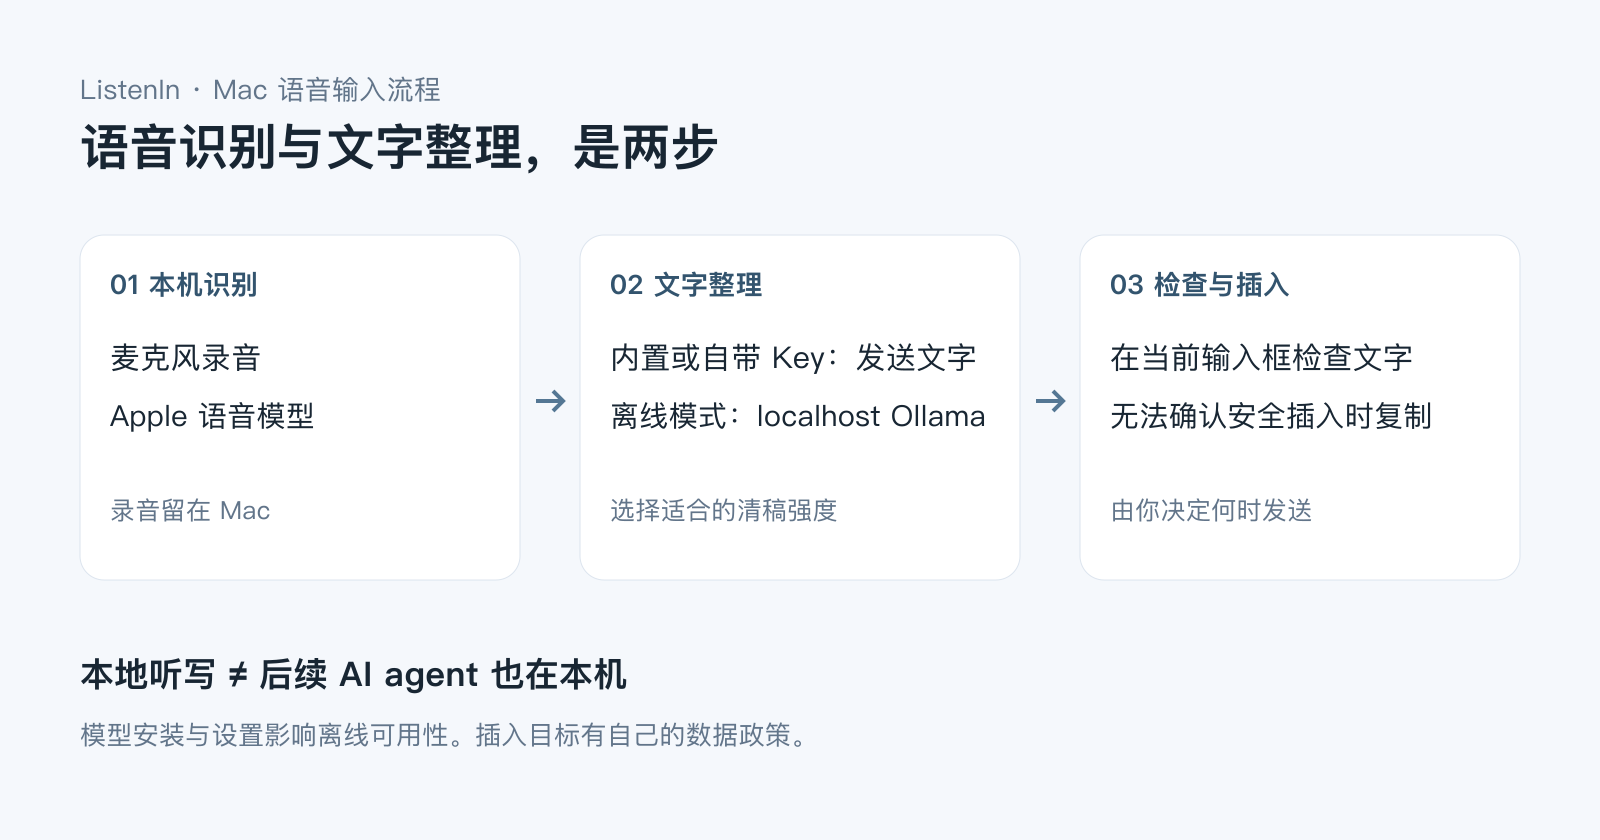
ListenIn 支持中文句子夹杂英文词,不需要每说一个英文词就切换语言。识别在 Mac 上完成,清稿处理识别出的文字。本文说明错误可能出现在哪一步、现有纠错机制能做什么,以及怎样在自己的工作场景中检查结果,不声称比其他 App 有更高的准确率。
错在语音识别,还是文字清稿?
打开 ListenIn → 听写历史,对照原始转写和最终输出,找出英文第一次发生变化的位置。
| 原始转写 | 最终输出 | 应该检查什么 |
|---|---|---|
| 英文已经错了 | 同一个错误 | 识别没有听准,清稿也缺少足够证据 |
| 原稿有错 | 最终正确 | 这次纠错有效,还需要放进其他语境复测 |
| 原稿正确 | 最终换成另一个词 | 清稿或替换规则改动了本该保留的词 |
| 单词正确 | 指令意思变了 | 整理时丢失了条件或修改范围 |
例如,insight 变成 inside,如果原稿里已经是 inside,就先排查识别。unchanged 变成 changed 还涉及意思改变,因为它丢掉了否定条件。这些只是诊断示例,不意味着所有 inside 或 changed 都应该被自动替换。
如果原稿正确,降低清稿强度并检查替换规则。换麦克风无法修复后续的文字改写问题。
ListenIn 当前怎样处理中英混说
识别和清稿分成两步,所以可以在不同环节补强,但每种机制都有边界。
| 机制 | 适合处理 | 能力边界 |
|---|---|---|
| Apple 本机语音识别 | 产生中文和英文原稿 | 受语言模型、口音、麦克风和语境影响 |
| 保守的英文音频校验 | 用录音检查部分可疑英文词 | 需要可用的时间信息和证据,模棱两可时保留原词 |
| 清稿指令 | 在语境中修正合理的近音词,保留夹杂英文 | 语境通顺不代表可以编造另一个技术词 |
| 个人词典 | 提供重复使用的词汇正确写法 | 不会重新训练 Apple 语音模型 |
| 显式替换规则 | 在本机按全局或指定 App 修正已知错误 | 错误规则可能反复改坏本来正确的词 |
音频校验只检查有限片段,不会再完整转写整段录音。信息不足或超过时间预算时,可以跳过;模型也不应仅因为另一个表达更顺,就替换高置信度或受保护的词。这些措施都不能保证每段录音一定还原出你想说的英文。
先补词汇,再谨慎使用精确规则
从实际常用词开始:项目名、人名、产品拼写和较少见的英文词。打开 设置 → 词典,加入正确写法,然后放进完整句子测试,不只单独念词。词典指南分别解释了词汇提示、学习纠错和显式规则。
如果某个错误短语稳定重复,可以在 词典 → 精确替换 中添加显式替换。选择最小、含义明确的短语;只在一个 App 中有效的规则,就限定到那个 App。例如,项目里的 right the migration note 可以考虑短语级纠错,但全局设置 right → write 会改坏描述「右侧」的普通文字。
不要把每次编辑都当作永久纠错指令。检查学习建议,删除或撤销会改动正确文字的规则。换 Mac 前,先导出词典备份。
词表提供的是上下文,不是识别保证。如果正确词始终无法可靠出现,先拼读一次或在发送前手动修正。
用一小组句子检查意思是否保留
使用接近自己工作的句子。下面是建议测试的输入,不是已经完成的公开准确率测评。
| 测试句子 | 检查项 |
|---|---|
| 保留这一段 unchanged,只调整下面的 layout。 | 保留否定条件,只修改下方布局 |
| 这里需要的是 user insight,不是 inside 的位置。 | 两个英文词按各自含义留下 |
| 先检查 cache,别直接清掉。 | 保留「不要清理」的限制 |
| 我想 write anything in plain words。 | 动词和短语合理,不新增内容 |
| 这个方案可能可行,先确认,不要直接上线。 | 保留不确定性和发布限制 |
在备忘录和实际目标 App 中,每个句子多试几次,分别比较原稿与成稿。把错误术语、丢失条件、不必要改写和插入失败分开记录,一个总的「准确率」会掩盖到底哪一步出了问题。
比较不同 App 时,使用同一麦克风、所选语言、清稿模式和模型。也放入一条原本就正确的对照句。如果修好一句,却改坏另一句,就不能算整体改善。
选择中文,会不会排斥英文词?
不会把这两个问题直接等同起来:识别语言和句中夹杂英文是不同层面。先选择适合主要句子的语言,再测试常用英文词。Apple 不同引擎和语言资源的可用性也不同。Apple 的Mac 听写指南介绍系统语言设置;ListenIn 语言模型故障指南说明本机识别所需的资源。
繁简体输出又是另一项设置。「始终繁体」或「始终简体」控制中文写法,不负责翻译英文标识符。具体见繁简输出指南。
换成本地模型,会不会解决?
它改变的是清稿环节,不是原始识别器。离线模式使用 localhost Ollama,可以把清稿文字留在 Mac 上,但小模型不一定能稳定遵守纠错和保留规则。原稿已经出错时,仅换清稿模型不能保证修好。
先按本地配置指南设置,再复测同一批句子。首次加载模型和模型已加载时的等待应分开观察,同时保留原稿,避免把识别变化和清稿变化混在一起。
内置清稿发送识别出的文字,不发送麦克风录音;自带 API Key 的清稿发送文字到所选提供方。远程或局域网模型也不等于 localhost,本机与网络的完整边界见安全说明。
什么时候应该手动修正?
发送给别人或编码 agent 前,检查路径、数字、代码符号和有歧义的名字。模型选出一句合理的话,不足以证明它符合录音。自动插入无法保证安全时,ListenIn 用复制卡片保留结果,手动粘贴即可,不必对着已经变化的输入目标重复录音。
报告问题时,可以提供实际想说的短语、原稿、成稿、所选语言和模型,以及是否只在一个 App 中发生。只分享你愿意披露的文字。设置 → 报告问题 提供反馈入口,说明一个单词错误不需要附上整段私密录音。
在自己的 Mac 上试一下
免费档不用注册;音频不出本机。
由 ListenIn 产品方发布;第三方信息以文中标注的来源与日期为准。